Neden FKM Tasarımındaki Teorik Planlar Sahada Çöker


Yönetim kurulu toplantılarında slayt slayt sunulan, ISO 22301 ve ISO 27031 gibi uluslararası standartlarla belgelenmiş, yüzlerce sayfalık dosyalar halinde arşivlerde duran Felaket Kurtarma Merkezi (FKM) planlarını hepimiz biliriz. Kağıt üzerinde bu planlar kusursuzdur: bir kriz patlak verdiğinde sistemler saniyeler içinde ayağa kalkacak, veri kaybı yaşanmayacaktır. Ne var ki gerçek bir felaket kapıyı çaldığında masa başında hazırlanan bu teorik çerçeveler çoğu zaman paramparça olur, işe yaramaz hale gelir, hatta kaosu büyütür.
Rakamlar da bu tabloyu doğruluyor. Kurumların yüzde 42'si felaket kurtarma planlarını hiçbir şekilde test etmiyor. Test edenlerin büyük kısmı ise steril, izole, sonucu baştan belli senaryolarla yetiniyor. Dijital kesintilerin sıklaştığı bir dönemde organizasyonların yalnızca yüzde 20'si olası bir kesintiye karşı kendini "tamamen hazır" sayabiliyor; geri kalan çoğunluk ise elindeki güvenlik ağının aslında bir illüzyondan ibaret olduğunu içten içe biliyor.
Peki milyonlarca lira harcanan bu Felaket Kurtarma stratejileri neden kağıt üzerinde kalıp sahada çöküyor? Fiziğin sert kurallarından insan psikolojisine, sessizce biriken konfigürasyon farklarından kaos mühendisliğine kadar uzanan bu tabloyu gerçek vakalar ve verilerle birlikte adım adım ele alalım.
1. RTO ve RPO İllüzyonu: Fizikle Tartışılmaz
Her felaket kurtarma planının kalbinde iki metrik yatar: Kurtarma Süresi Hedefi (RTO), yani sistemlerin ne kadar sürede ayağa kalkacağı; ve Kurtarma Noktası Hedefi (RPO), yani kabul edilebilir en fazla veri kaybı. Yöneticiler çoğunlukla "sıfır veri kaybı, saniyeler içinde kurtarma" gibi gerçeklikten kopuk hedefler koyar. Oysa teknoloji fizik kurallarına tabidir ve bu kurallarla pazarlık edilemez.
Sıfır veri kaybı hedefi, birincil ve ikincil merkezler arasında verinin eşzamanlı (senkron) olarak kopyalanmasını gerektirir. Fakat fiber optik kablolardaki ışığın hızı ve ağ gecikmesi (latency) sabit bir sınır çizer: bu mimari ancak iki merkez arasındaki mesafe 50-100 kilometreyi geçmediğinde işler. Öte yandan büyük bir deprem ya da sel riskinden korunmak isteyen kurumların FKM'yi yüzlerce kilometre öteye kurması stratejik bir zorunluluktur. Bu mesafe ise senkron kopyalamayı fiziksel olarak imkânsızlaştırır ve kurumu asenkron mimariye iter. Asenkron çalışan bir sistem, doğası gereği 5 dakika ile 1 saat arasında değişen bir veri kaybı riskini de beraberinde getirir. Yani mesafe büyüdükçe "hiç veri kaybetmeyeceğiz" iddiası fiziğe çarpıp dağılır.
İşin bir başka boyutu da sistemlerin açılış sırasıdır. Teoride 15 dakikalık bir RTO hedeflenmiş olabilir; ama modern mimarilerde yüzlerce sunucu aynı anda devreye giremez. Önce güvenlik duvarları, ardından Active Directory, sonra veritabanı tutarlılık denetimleri, en sonunda da web arayüzleri belirli bir sırayla ayağa kalkmak zorundadır. Aradaki sağlık kontrolleriyle birlikte bu katı sıralama, manuel yürütülen süreçlerde günler alabilir.
Küresel istatistikler de bu tabloyu destekliyor: ortalama bir BT kesintisinin çözülme süresi 196 dakikayı, yani üç saati aşıyor; plansız bir kesintiyi 60 saniyenin altında toparlayabilen kurumların oranı ise yalnızca yüzde 2. Beklenti ile gerçeklik arasındaki bu uçurumun kurumlara maliyeti hafif değil: yıllık kesinti maliyeti şirket başına 76 milyon dolara kadar çıkabiliyor, kesintiler doğrudan gelir kaybının yanında yüzde 90 oranında müşteri güveni kaybına ve marka zedelenmesine yol açıyor. Bunun altında yatan en büyük nedenlerden biri de şu: kurumların yüzde 39'unda hangi sistemin ne zaman, hangi öncelikle kurtarılacağını belirleyen resmi bir İş Etki Analizi (BIA) süreci dahi yok.
Bu eksiklik tesadüf değil; İş Etki Analizi yapmak, hangi sistemin şirket için gerçekten kritik olduğunu, hangisinin birkaç saat beklese de sorun yaratmayacağını ortaya koyan zahmetli, disiplinler arası bir çalışmadır. Finans, operasyon ve BT ekiplerinin birlikte oturup önceliklendirme yapması gerekir; birçok kurum ise bu sıkıcı ama hayati adımı atlayıp doğrudan teknoloji satın almaya geçer. Sonuçta elde edilen RTO/RPO rakamları, gerçek iş önceliklerine değil, satıcının sunduğu paket çözümün teknik kapasitesine göre belirlenmiş olur. Kriz anında hangi sistemin önce açılacağına dair net bir sıralama yoksa, herkes kendi sistemini "en kritik" ilan eder ve zaten kısıtlı olan kurtarma süresi çekişmelerle harcanır.
2. Bağımlılık Körlüğü ve SaaS Yanılgısı
Teorik planların en büyük metodolojik açığı, BT sistemlerini birbirinden kopuk, izole kutular gibi ele almasıdır. Oysa bugünün altyapıları binlerce görünmez bağla birbirine dolanmış devasa ekosistemlerdir. Bir sunucuyu yedekten geri döndürmek, o uygulamanın çalışacağı anlamına gelmez.
Buna "Bağımlılık Körlüğü" diyoruz ve kriz anında saatler kaybettiriyor. Diyelim ki FKM'de veritabanınızı başarıyla ayağa kaldırdınız. Ama Active Directory ya da bulut tabanlı kimlik doğrulama servisi henüz devrede değilse, uygulama çalışsa dahi kimse sisteme giremez. Ya da veritabanı sorunsuz açılmıştır ama uygulamanın dosya okumak için ihtiyaç duyduğu paylaşımlı ağ depolama (NAS) farklı bir IP adresiyle çevrimdışı kalmıştır. Sistemler gelişigüzel bir sırayla ayağa kaldırılmaya çalışıldıkça zaman aşımları birikir, ardından ikincil çökmeler başlar.
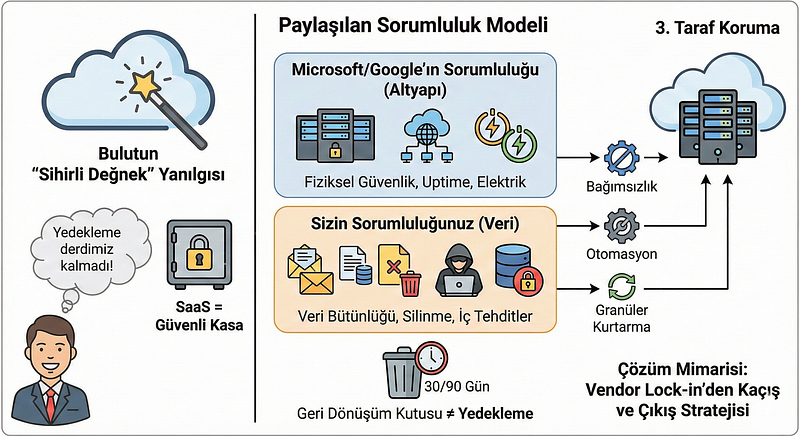
Bu körlüğün bir başka yüzü de SaaS platformlarına duyulan sorgusuz güvendir. Şirketler Microsoft 365 veya Google Workspace gibi platformların veri kaybetmeyeceğine körü körüne inanır. Oysa BT profesyonellerinin yüzde 87'si 2024'te SaaS kaynaklı veri kaybı yaşamış, yüzde 35'i bu veriyi geri getirmek için haftalarca uğraşmıştır. Bulut sağlayıcı altyapıyı korur ama fidye yazılımıyla şifrelenen veriyi geri getirmek tamamen kurumun kendi sorumluluğundadır.
Bu yanılgının kökeninde "paylaşımlı sorumluluk modeli"nin yeterince anlaşılmaması yatar. Bulut sağlayıcı sunucuların, ağın, veri merkezinin fiziksel güvenliğini üstlenir; ama uygulama katmanındaki yanlış yapılandırma, silinen bir klasör, kötü niyetli bir iç kullanıcı ya da fidye yazılımının şifrelediği dosyalar müşterinin sorumluluğunda kalır. Sözleşmelerin küçük puntolarında yazan bu ayrım, kriz anına kadar kimsenin dikkatini çekmez. Üstelik bağımlılık zinciri tek bir SaaS ürünüyle de sınırlı değildir: bir CRM'in çalışması için ödeme ağ geçidi, e-posta servisi ve tek oturum açma (SSO) sağlayıcısı gibi başka üçüncü taraf hizmetlerin de aynı anda ayakta olması gerekir. Zincirin tek bir halkası koptuğunda bütün iş akışı durur, ama FKM planı genellikle bu zincirin yalnızca kendi kontrolündeki parçasını kapsar.
3. Sessiz Katil: Konfigürasyon Kayması
Yüksek erişilebilirlik ve FKM sistemlerinde yaşanan çökmelerin neredeyse tamamının, kök nedeni "Konfigürasyon Kayması"dır. Teoride birincil veri merkeziyle FKM'deki donanım, yazılım sürümleri ve ağ kuralları birebir aynıdır; bu simetri sayesinde yük devretme (failover) sorunsuz işler.
Ama gerçek hayat düzenli değildir. Birincil sistemde gece yarısı uygulanan acil bir yama, eklenen bir bellek modülü ya da değiştirilen bir VLAN etiketi, ikincil merkeze anında yansımaz. Aylar geçtikçe bu küçük farklar kartopu gibi büyür. Felaket anında trafik FKM'ye devredildiğinde yeni kod eski işletim sistemiyle çakışır, yetkilendirme reddedilir ve FKM saniyeler içinde çöker.
Manuel süreçlere dayanan geleneksel merkezlerde bu kaymayı önlemek neredeyse imkânsızdır; onlarca Excel tablosunu göz kararı karşılaştırmak hataya son derece açıktır. Bugün ileri düzey FKM tasarımları bu asimetriyi önlemek için tüm altyapıyı "Kod Olarak Altyapı" (Infrastructure as Code) yaklaşımıyla yönetiyor.
4. DNS Gecikmeleri ve Yeniden Deneme Fırtınaları
Diyelim her şeyi doğru yaptınız: sunucular açıldı, veriler yerinde. Ama kullanıcı trafiğini yeni FKM'ye yönlendiremiyorsanız bütün bu emek boşa gider.
Teorik FKM planları, DNS kayıtlarının "Time To Live" (TTL) süresini 60 saniye gibi düşük tutarak IP değişikliğinin internete anında yayılacağını varsayar. Oysa gerçek dünyada son kullanıcı cihazları, tarayıcılar ve internet servis sağlayıcıları performans uğruna bu düşük TTL değerlerini görmezden gelip eski adresi kendi önbelleklerinde uzun süre saklar. Siz "15 dakikada ayağa kalktık" diye rahatlarken, milyonlarca kullanıcının cihazı saatlerce çökmüş olan eski sunucuya bağlanmaya çalışmaya devam eder.
Daha vahim olanı ise "Yeniden Deneme Fırtınaları" adı verilen basamaklı çöküşlerdir. POS cihazları veya mobil uygulamalar arka uçtaki sunucuya ulaşamadığında, içlerindeki yazılım saniyede onlarca kez agresifçe yeniden bağlanmayı dener. Milyonlarca cihazın bu eşzamanlı saldırısı ağ trafiğini yüzde 400'e varan oranda artırıp yeni açılan FKM sunucularını boğar. Teorik planlar yalnızca normal kapasiteyi hesaba katar; sistemin kendi kendine yarattığı bu "kendi kendini vuran DDoS" etkisini öngöremez. Oysa altyapıda yalnızca yüzde 5'lik bir kapasite kaybı bile finansal işlemlerde yüzde 40'a varan başarısızlığa yol açabiliyor.
İşin garibi, bu fırtınayı büyüten şey aslında iyi niyetli bir mühendislik kararıdır: yazılımcılar bağlantı koptuğunda kullanıcıyı bekletmemek için otomatik yeniden deneme mantığı ekler. Ama binlerce istemci aynı anda, aynı aralıklarla yeniden denediğinde bu mantık kolektif bir silaha dönüşür. Deneyimli ekipler bu riski "üstel geri çekilme" ve rastgele gecikme teknikleriyle azaltmaya çalışır; her istemcinin yeniden deneme aralığını biraz farklılaştırarak dalganın tek bir anda değil, zaman içine yayılarak gelmesini sağlarlar. Teorik FKM dokümanlarında bu detaya neredeyse hiç yer verilmez, çünkü doküman kapasiteyi statik bir sayı olarak ele alır; oysa gerçek trafik, felaket anında kendi kendini besleyen dinamik bir dalgadır.
5. Bilişsel Çöküş ve İşin Sosyolojisi
En büyük kör noktalarımızdan biri, kriz anında sistemi yönetecek olan insanı, onun nöropsikolojik sınırlarıyla birlikte denkleme katmamaktır. Sistem çöktükten sonraki ilk dakikalar üst yönetimden gelen baskı, art arda çalan alarmlar ve bilgi bombardımanıyla doludur.
Bilişsel Yük Teorisi'ne göre karmaşık, özellik yüklü arayüzler operatörün zihinsel kapasitesini saniyeler içinde doldurur. Zihinsel olarak tükenen bir uzman, o stres altında yanlış sunucuyu kapatmak gibi ölümcül hatalar yapabilir. Nitekim veri kaybı vakalarının yüzde 25'inin altında insan hatası yatıyor.
Havacılıkta pilotların kullandığı "Tanıma Odaklı Karar Verme" modeli BT krizlerinde işe yaramaz; çünkü BT ekipleri bu krizleri yeterince test etmediğinden durumu zihinsel olarak "tanıyamaz" ve yavaş, analitik düşünmeye mecbur kalır. Bu noktada önyargılar devreye girer: yönetici krizin ilk saniyesinde gördüğü alakasız bir hata kaydına takılıp kalır ya da baştan inandığı teoriyle uyumlu verileri seçmeye başlar.
İşin sosyolojik boyutu da acı bir gerçeği ortaya koyar. Deprem veya sel gibi doğal afetlerde planlar personelin derhal VPN'e bağlanmasını emreder. Ama araştırmalar gösteriyor ki evi hasar gören, ailesine ulaşamayan bir çalışan şirketin veritabanını değil, ailesinin güvenliğini önceliklendirecektir. Bu da manuel insan müdahalesine dayanan failover süreçlerinin felaket anında neden işlemediğinin en insani kanıtıdır.
6. Akbank ve OVHcloud Vakaları
Teorinin sahada nasıl çöktüğünü görmek için uzağa gitmeye gerek yok.
Akbank'ın 2021'deki kesintisi dışarıdan gelen bir siber saldırı değildi. IBM DB2 ana bilgisayarına gece yarısı uygulanan rutin bir güncellemenin ters gitmesiyle başladı. İşlemler geri alınmaya çalışılırken veritabanı kilitlendi. Normalde ikincil FKM devreye girmesi gerekirken, işlem kayıtlarının yedeğinin alınmasında mimari bir sorun yaşandı ve birincil saha kaynaklı hata domino etkisiyle tüm katmanlara yayıldı. O bilişsel yük altında dışarıdan gelen uzman destek tekliflerinin başlarda reddedilmesi krizin 43 saat sürmesine, tüm bankacılık kanallarının felç olmasına yol açtı.
OVHcloud'un 2021'deki Strasbourg veri merkezi yangını ise fiziksel gerçekleri hepimizin yüzüne çarptı. Yangın UPS odasından başladı. Görev-kritik veri merkezlerinde oksijeni kesmeyen, elektroniğe zarar vermeyen temiz gazlı söndürme sistemleri kullanılması gerekirken tesisin yetersizliği itfaiyeyi tonlarca su kullanmak zorunda bıraktı. Su, mikroçipleri ateş kadar acımasızca mahvetti. Müşterilerin çoğu, altyapıları büyük bir bulutta olduğu için verilerinin otomatik yedeklendiğini sanıyordu; bu paylaşımlı sorumluluk yanılgısı yüzünden sözleşmesini dikkatle okumayan şirketler verilerini sonsuza dek kaybetti. Dahası, İngiltere'de yapılan bir araştırmaya göre yöneticilerin yüzde 50'si yedeklerini birincil sistemle aynı binada tutuyordu; OVH yangınında kül olan 12.000 sunucuyla birlikte aynı binadaki "yedekler" de kül oldu, coğrafi ayrım kuralının ihlali şirketleri iflasın eşiğine getirdi.
7. Yedekleri Zehirleyen Fidye Yazılımları
Geleneksel FKM planları disk arızası ya da sel gibi eski nesil sorunlara göre kurgulanmıştır. Oysa bugünün en büyük kesinti tetikleyicilerinden biri fidye yazılımlarıdır. Modern saldırgan grupları sisteme sızdığında veriyi hemen şifrelemez; aylarca sessizce beklerler.
Bu sessizlik döneminde zararlı yazılım, şirketin düzenli aldığı yedeklerin içine sızar. Şirket saldırıyı fark edip son yedeğe döndüğünde aslında fidye yazılımının kendisini sisteme geri yüklemiş olur. Daha da kötüsü, gelişmiş saldırganlar doğrudan yedekleme sistemlerini hedef alır. Air-gap, yani ağa bağlı olmayan ve asla değiştirilemez/silinemez (immutable) yedekleme mimarisi kurulmadıysa, milyon dolarlık FKM yatırımı saldırganların elinde bir oyuncağa dönüşür.
8. Statik Dokümanlardan Kaos Mühendisliğine
İnsanın hataya açık olduğu, ağ bağımlılıklarının çığ gibi büyüdüğü, konfigürasyon kaymalarının sistemleri içten kemirdiği bu tabloda SharePoint'te duran statik dokümanlar bizi kurtaramaz. Hafta sonu gece yarısı, her adımı önceden bilinen steril bir ortamda yapılan yılda bir kerelik FKM tatbikatları sadece personeli rahatlatır. Gerçek felaketler ise öğlen mesai saatinde, hiç beklenmedik olaylar olarak gelir.
Modern mimari bu soruna Kaos Mühendisliği ile çözüm buluyor. Netflix'in Chaos Monkey aracıyla tanınan bu yöntem, üretim ortamındaki çalışan sistemlere kasıtlı ve kontrollü arızalar enjekte etme bilimidir. Bulut altyapısındaki bir Kubernetes node grubu aniden kapatılır ve DNS yönlendirmelerinin trafiği saniyeler içinde FKM'ye nasıl aktardığı canlı olarak ölçülür. Ağ paketleri bilerek düşürülür ya da araya mikrosaniyelik gecikmeler eklenerek sistemin tepkisi test edilir. İki veri merkezi arasındaki iletişim kasıtlı olarak kesilir, her iki taraf da kendini ana sunucu sanıp veri yazmaya çalışır; kaos mühendisliği sistemin bu "bölünmüş beyin" durumunu otonom olarak nasıl çözdüğünü acımasızca sınar. Sistemler belirlenen RTO/RPO hedefleri içinde kendi kendini onaramıyorsa tasarım başarısız sayılır, sorun kod seviyesinde giderilir ve sistem yeniden bu kaos döngüsüne tabi tutulur.
Gelecek Vizyonu
FKM tasarımlarındaki çöküşler basit bir BT anomalisi değil; insan bilişinin, fizik kurallarının ve teknolojik karmaşıklığın kaçınılmaz bir sonucudur. FKM, rafta tozlanan bir regülasyon belgesi değil, sürekli kodlanan, yaşayan, evrimleşen bir organizma olmak zorundadır.
Eski dünyanın statik yaklaşımları, modern çok katmanlı mimarilerin, yeniden deneme fırtınalarının ve fidye yazılımlarının karşısında çaresiz kalıyor. Geleceğin dayanıklı BT organizasyonları artık "Bir planımız var mı?" diye sormayı bırakıp, "Felaket kurtarma otomasyonumuz kaos mühendisliği yöntemleriyle üretim ortamında her gün kendini kanıtlayabiliyor mu?" sorusunu sormalı. Yönetim kurullarının bu konuyu yalnızca "bilgi işlem departmanının işi" olarak görmekten vazgeçmesi şart. Kurumlar ya sistemlerini her gün kontrollü bir kaosla eğitmeyi seçecek ya da hazırlıksız yakalandıkları ilk gerçek kaosta yok olma riskiyle yüzleşecek.

Yorumlar